Conosci lo stato di salute della tua infrastruttura IT? Server, reti e applicazioni generano continuamente metriche, log ed eventi. Spesso, però, queste informazioni sono frammentate e manca una visione centralizzata che permetta di interpretarle nel loro insieme.
In questo articolo vedremo come l'integrazione dell'intelligenza artificiale con la piattaforma open source Zabbix permetta di:
- raccogliere, correlare e visualizzare le informazioni, offrendo ai team IT una visione centralizzata dei sistemi
- aggiungere un livello di analisi predittiva al monitoraggio dell'infrastruttura, per correlare metriche, log ed eventi, valutare il rischio di incidenti e intervenire con maggiore tempestività.
Perché l’infrastructure monitoring tradizionale non è più sufficiente
Partiamo con un po’ di contesto. L’Infrastructure Monitoring è un insieme di strumenti e processi che consentono di monitorare lo stato di salute di un’infrastruttura IT, comprensiva di server, reti, database, applicazioni e macchine virtuali. Questi componenti, e molti altri, vengono osservati in tempo reale attraverso la raccolta di metriche, log ed eventi, con l’obiettivo di evidenziare anomalie che si possono ripercuotere sulle performance e la continuità dei sistemi IT.
Il monitoring esiste da decenni, ma recentemente le infrastrutture IT sono diventate molto più articolate, mentre la crescente digitalizzazione dei processi aziendali ha reso i sistemi informativi sempre più critici per il business. Parallelamente, clienti e utenti si aspettano servizi disponibili 24 ore su 24, tempi di risposta ridottissimi e un’esperienza digitale priva di rallentamenti.
L’approccio tradizionale rischia di non essere sufficiente per questo scopo perché, nella maggior parte dei casi, segnala un problema quando questo ha già iniziato a manifestarsi. Inoltre, se le soglie e le regole di monitoraggio non sono configurate perfettamente, il sistema può generare un numero elevatissimo di alert, tra cui molti falsi positivi.
Zabbix: una piattaforma open source su cui costruire un monitoraggio evoluto
Tra le soluzioni più apprezzate per il monitoring dell’IT c’è Zabbix, piattaforma open source progettata per monitorare in modo centralizzato lo stato di salute di infrastrutture IT di qualsiasi dimensione.
Grazie a un’architettura flessibile e configurabile, Zabbix raccoglie in tempo reale metriche come utilizzo di CPU, memoria e I/O, log, trap SNMP, dati dagli agent e metriche applicative, ad esempio tramite JMX e HTTP check. Le informazioni raccolte vengono rese disponibili attraverso dashboard e sistemi di notifica personalizzabili, che permettono ai team IT di individuare rapidamente eventuali anomalie e intervenire con tempestività.
La sua natura open source, unita a un ecosistema maturo e alla possibilità di essere esteso e personalizzato, lo ha reso negli anni una piattaforma di riferimento per il monitoraggio e l’observability dei sistemi IT moderni.
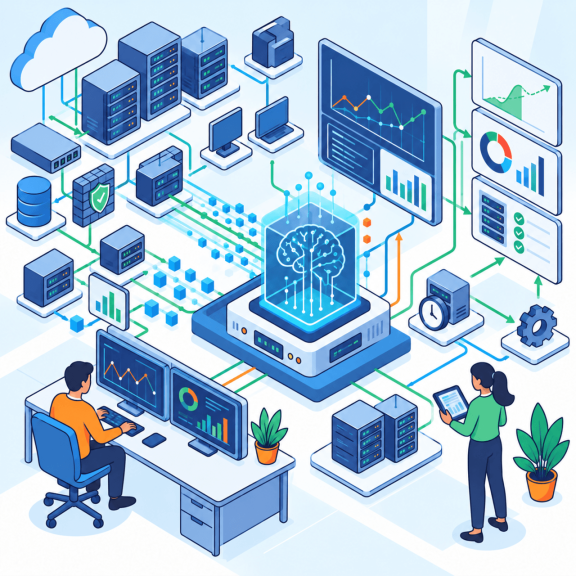
La capacità di Zabbix di raccogliere grandi quantità di dati lo rende inoltre la base ideale su cui costruire un livello superiore di monitoraggio: l’AI Infrastructure Monitoring, che affianca al paradigma reattivo funzionalità predittive in grado di anticipare il verificarsi di anomalie e incidenti.
AI Infrastructure Monitoring: dal rilevamento alla previsione degli incidenti
Le capacità predittive dell’intelligenza artificiale hanno catturato da tempo l’attenzione delle imprese. In particolare, i modelli di Machine Learning sono in grado di individuare correlazioni, pattern ricorrenti e comportamenti dei dati che difficilmente sarebbero riconoscibili da un essere umano.
La previsione di scenari futuri è un principio che le aziende mature adottano in molti ambiti, dalla previsione della domanda di prodotto alla manutenzione predittiva degli impianti industriali. Il meccanismo è relativamente semplice da comprendere: gli algoritmi di Machine Learning analizzano i dati storici per individuare correlazioni, pattern ricorrenti e sequenze di eventi che sono spesso associati a un determinato esito. Quando rilevano nuovamente configurazioni simili, sono in grado di stimare la probabilità che quello stesso evento si verifichi, associando alla previsione un livello di affidabilità statistica.
Nella maggior parte dei casi, un guasto, un degrado delle prestazioni o un'interruzione di servizio non si verificano in modo improvviso, ma sono preceduti da una combinazione di segnali deboli: variazioni anomale nell'utilizzo della CPU, crescita progressiva dello spazio di memoria, aumento della latenza, errori ricorrenti nei log, rallentamenti di determinati servizi o altri comportamenti che, presi singolarmente, potrebbero apparire trascurabili ma in realtà non lo sono.
Il risultato non è un semplice alert basato sul superamento di una soglia, ma uno scoring che indica quanto sia concreto il rischio che un determinato evento si verifichi. Sarà poi il professionista IT a decidere se intervenire oppure no, disponendo però di informazioni molto più ricche e contestualizzate rispetto a quelle offerte dal monitoraggio tradizionale.
IT Service Management Open Source: come integrare OTRS, GLPI e Zabbix
Perché integrare l’AI nell’Infrastructure Monitoring
L’adozione dell’AI nell’Infrastructure Monitoring rappresenta un cambiamento nel modo in cui vengono gestite le infrastrutture e i sistemi IT.
Esistono diversi motivi per cui le aziende dovrebbero valutarne l’implementazione:
Prioritizzazione intelligente degli alert: non tutte le anomalie hanno lo stesso impatto sul business. Attraverso l’analisi del contesto e l’attribuzione di uno scoring di rischio, l’AI aiuta i team IT a concentrarsi prima sugli eventi realmente critici.
Riduzione dei falsi positivi: la capacità di correlare metriche, log ed eventi provenienti da sorgenti differenti permette di ridurre sia i falsi positivi sia la ridondanza degli alert, evitando che lo stesso fenomeno generi più segnalazioni ripetute. Si riducono così il rumore di fondo e il fenomeno dell’alert fatigue.
Maggiore continuità operativa e performance: individuare con anticipo le condizioni che potrebbero evolvere in un incidente consente di pianificare gli interventi prima che si verifichino rallentamenti o interruzioni dei servizi.
Migliore utilizzo delle competenze IT: riducendo il tempo dedicato all’analisi manuale degli alert e alla gestione delle emergenze, i team possono concentrarsi su attività come l’ottimizzazione dell’infrastruttura e l’innovazione.
Decisioni più rapide e consapevoli: con l'adozione di questo approccio è possibile ottenere informazioni contestualizzate e una stima della probabilità che un determinato evento si verifichi. L’AI supporta quindi la valutazione del rischio senza sostituire il giudizio del professionista, che mantiene il controllo sulle decisioni e sulle eventuali azioni da intraprendere. Questo patrimonio informativo non supporta solo la gestione dei singoli incidenti, ma anche decisioni più strategiche in materia di capacity planning, ottimizzazione delle risorse e pianificazione dell’evoluzione dell’infrastruttura.
Scoring e auto-remediation: Make IT porta l’AI nell’ecosistema Zabbix
L'approccio di Make IT al monitoring moderno combina la solidità, l'affidabilità e la capacità evolutiva di Zabbix con i vantaggi dell'analisi predittiva basata su algoritmi di Machine Learning.
L'obiettivo è mettere a disposizione uno strumento capace di affrontare la crescente complessità delle infrastrutture digitali attraverso un duplice supporto: da un lato, fornire informazioni più ricche e contestualizzate per migliorare il processo decisionale; dall'altro, introdurre un livello di automazione sempre maggiore nella gestione operativa dei sistemi.
L’evoluzione, infatti, non si ferma alla previsione. Nei casi in cui lo scoring preveda uno scenario pressoché certo, la soluzione può attivare automaticamente workflow di remediation configurati in precedenza dagli amministratori. È importante sottolineare che non è l’intelligenza artificiale a decidere cosa fare: l’AI stima la probabilità che si verifichi un determinato evento, mentre l’intervento viene affidato a procedure deterministiche definite a priori, così da garantire il massimo livello di affidabilità.
A seconda dello scenario, i workflow possono prevedere, ad esempio, l’allocazione automatica di nuove risorse a un server, il riavvio controllato di un servizio, il ripristino di un nodo Kubernetes, l’apertura di un ticket o l’invio di notifiche ai team competenti.
Per le azioni più critiche, i workflow devono prevedere condizioni di sicurezza, meccanismi di rollback e opzioni di approvazione manuale. Prima dell’attivazione in produzione, le procedure vanno inoltre testate in ambienti non produttivi.
Il risultato è una gestione dell’infrastruttura più tempestiva, capace di ridurre i tempi di intervento e, in molti casi, evitare che un’anomalia si trasformi in un’interruzione del servizio.
Conclusione
Le infrastrutture IT producono ogni giorno una quantità crescente di metriche, log ed eventi. Disporre di queste informazioni è indispensabile, ma non sempre sufficiente per individuare tempestivamente le situazioni che richiedono un intervento.
L'AI Infrastructure Monitoring aggiunge un livello di analisi che aiuta a correlare i dati raccolti, stimare il rischio di incidenti e supportare le decisioni dei team IT. Integrata con piattaforme come Zabbix, consente di valorizzare il patrimonio informativo già disponibile e, dove previsto, di attivare workflow automatici definiti dagli amministratori.
Più che sostituire il monitoraggio tradizionale, l'intelligenza artificiale ne amplia le potenzialità, offrendo strumenti per gestire l'infrastruttura in modo più tempestivo, consapevole ed efficace.